
利用Pandas計算資料集中所有數值特徵的皮爾森相關係數,並使用Seaborn繪製帶有數值標籤的相關係數熱力圖,系統性排查多變數間的關聯強度。
一、實作前情境:告別視覺猜測,用數字量化關聯
昨天在Day 8繪製每日螢幕使用時數與眼部症狀的散佈圖時,意外發現迴歸趨勢線幾乎呈現水平狀態。
這引出了一個關鍵的統計疑問:
二、撰寫相關係數矩陣與熱力圖腳本
在Colab中新增儲存格,撰寫計算與繪製熱力圖的腳本:
# ==========================================
# Day 9:數值特徵皮爾森相關係數熱力圖
# ==========================================

import matplotlib.pyplot as plt
import seaborn as sns
import matplotlib.font_manager as fm
import numpy as np

# 確保引用中文字型
font_path = 'NotoSansTC-Regular.otf'
my_font = fm.FontProperties(fname=font_path)

# 1. 篩選數值型欄位並計算皮爾森相關係數
numeric_df = df.select_dtypes(include=['float64', 'int64'])
corr_matrix = numeric_df.corr(method='pearson')

# 2. 建立半三角遮罩(避免上下對稱重複顯示,讓圖表更簡潔)
mask = np.triu(np.ones_like(corr_matrix, dtype=bool))

# 3. 繪製熱力圖
plt.figure(figsize=(10, 8))
sns.set_theme(style="white")

# 定義欄位中文映射字典,方便座標軸對照閱讀
labels_map = {
    'Age': '年齡',
    'Daily_Screen_Hours': '每日螢幕時數',
    'Break_Frequency_Per_Hour': '每小時休息次數',
    'Eye_Dryness_Level': '眼睛乾澀程度',
    'Eye_Pain_Level': '眼痛程度',
    'Headache_Frequency_Per_Week': '每週頭痛頻率',
    'Sleep_Hours': '每日睡眠時數'
}
tick_labels = [labels_map.get(col, col) for col in corr_matrix.columns]

ax = sns.heatmap(
    corr_matrix,
    mask=mask,
    annot=True,
    fmt=".2f",
    cmap='coolwarm',
    vmin=-1,
    vmax=1,
    linewidths=0.5,
    cbar_kws={"shrink": .8}
)

# 4. 套用字型至座標軸與標題
ax.set_xticklabels(tick_labels, fontproperties=my_font, rotation=45, ha='right', fontsize=11)
ax.set_yticklabels(tick_labels, fontproperties=my_font, rotation=0, fontsize=11)
plt.title('數位用眼健康數值特徵相關係數熱力圖', fontproperties=my_font, fontsize=15, fontweight='bold', pad=15)

plt.tight_layout()
plt.show()

# 5. 印出數值矩陣表格作為對照
print("=== 數值相關係數矩陣 ===")
corr_matrix.round(3)
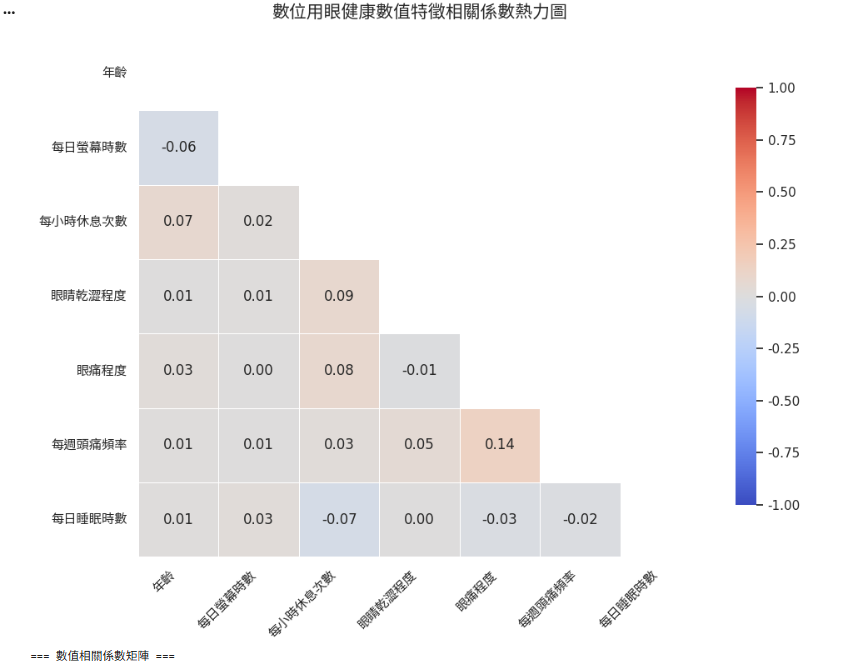
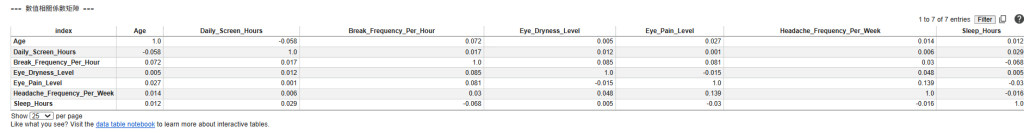
三、圖表解讀與統計觀察(真實矩陣數據剖析)
觀察相關係數矩陣與熱力圖的量化數值,可以歸納出三大關鍵發現:
1.核心假說量化驗證:螢幕暴露時數與眼部症狀近乎「線性獨立」
這組熱力圖證明了一件事:「眼部不適與疲勞風險並非單一數值的線性相加,而是受到類別行為(如是否抗藍光、身分差異)或非線性閥值的綜合調節」!


 iThome鐵人賽
 看影片追技術